rungent核心概念
搜索与知识
一次搜索覆盖你自己的搜索接口和你的文档。用户在 ⌘K 里用它,Agent 在作答前用它搜索,每个回答都会引用它用到的结果。
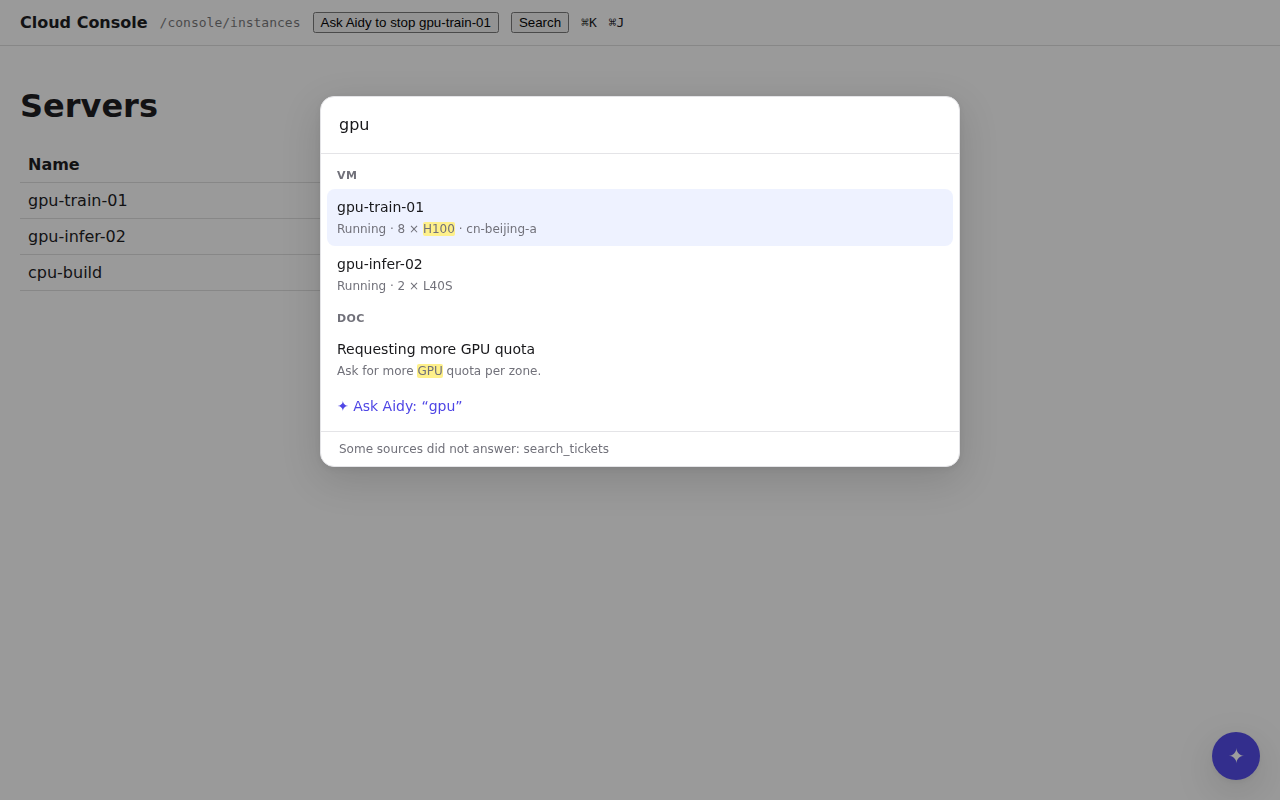
⌘K 搜索面板、Agent 的 search 工具、MCP 和 CLI(acme search "gpu")用的是同一个搜索。你的每个 role: search 操作都是一个来源;由 rungent 建好索引的文档是另一个来源,名叫 knowledge。
添加搜索来源#
搜索来源是一个 GET,带必填的 q 查询参数和可选的 limit:
"/api/vms/search": { "get": { "x-rungent": { "name": "search_vms", "role": "search" } } }
GET /api/vms/search?q=gpu&limit=10 按相关度从高到低返回结果:
{
  "hits": [
    { "type": "vm", "id": "vm-42", "title": "gpu-train-01", "excerpt": "Running · 8 × «H100» · cn-beijing-a",
      "url": "/console/instance/vm-42", "updatedAt": "2026-11-19T08:00:00Z" }
  ]
}
| 字段 | 含义 |
|---|---|
type |
必填。简短的类别(vm、doc),用于分组和筛选。 |
id |
必填。在同一类别内唯一。 |
title |
必填。 |
url |
必填。产品内的路径,或绝对 URL。 |
excerpt |
纯文本,最多 300 个字符;匹配的部分可以用 «…» 包起来。 |
updatedAt |
RFC 3339 时间。 |
content |
段落原文,最多 4000 个字符,只给模型看,用户永远看不到。 |
rungent 以用户身份调用每个来源,所以你的权限检查已经过滤好了结果。limit 默认 10,最大 50。
一次搜索覆盖所有来源#
rungent 同时询问所有来源,每个来源有自己的超时(默认 2 秒,最多 10 秒,用 timeoutSeconds 设置),再用倒数排名融合(reciprocal rank fusion)合并列表:一条结果的位置取决于各来源给它的排名,所以各来源的分数不需要可比。超时或出错的来源会列在 failed 里,其他来源照常返回。
添加你的文档#
用 rungent serve 时,两个环境变量就能在启动时为一个 Markdown 文件夹建索引:
RUNGENT_KNOWLEDGE_DIR=/srv/docs
RUNGENT_KNOWLEDGE_BASE_URL=https://docs.acme.example.com
文件夹下的每个 .md 和 .mdx 文件都成为一个页面。页面地址是基础 URL 加上去掉扩展名的路径(deploy/certificates.md 变成 …/deploy/certificates,index 文件代表所在文件夹);标题取 frontmatter 的 title,没有就取第一个标题。未改动的页面会跳过,所以重启的代价很小。基础 URL 也可以是你产品上的一个路径(/help)。
在代码里为文档建索引#
嵌入式部署,或者要决定谁能看到哪些文档时,用 rungent/knowledge。它跑在 Postgres、SQLite 或 D1 上,可以和 rungent 共用数据库:它的表都以 rungent_knowledge_ 开头。
import { readFile } from 'node:fs/promises';
import { createKnowledge } from 'rungent/knowledge';
import { postgresDriver } from 'rungent/sql/postgres';

const knowledge = createKnowledge({ driver: postgresDriver(process.env.DATABASE_URL!) });
await knowledge.migrate();

await knowledge.ingest('docs', [
  {
    id: 'deploy/certificates',
    title: 'Rotate certificates',
    url: '/help/deploy/certificates',
    markdown: await readFile('docs/deploy/certificates.md', 'utf8'),
  },
]);

const rungent = createRungent({
  // ...
  sources: [knowledge.source({ collections: (identity) => ['docs', `manuals/${identity.tenant}`] })],
});
ingest(collection, documents)添加或替换文档,返回{ updated, unchanged }。每次构建文档后运行它;未改动的文档会跳过,文字没变的章节保留原有的 embedding。remove(collection, ids)删除你的来源里已经没有的文档。collections接收用户的身份,挑出这个用户能搜索的范围,所以某个租户的私有手册只留在这个租户内。这个来源名叫knowledge;传name可以改名。embed和dimensions加上按语义搜索(搜「cert expiry」能找到「Rotate certificates」),可以用任何 embedding 服务:
const knowledge = createKnowledge({
  driver,
  embed: async (texts) =>
    (await openai.embeddings.create({ model: 'text-embedding-3-small', input: texts })).data.map((d) => d.embedding),
  dimensions: 1536,
});
没有 embedder 时,搜索只按词匹配,中文也支持。向量搜索每次查询最多读取被搜索集合中最新的 20,000 个章节。
写出便于引用的文档#
rungent 按 h1 到 h3 标题切分每个页面,超过约 800 token 的章节再按段落切开。一条结果的标题是 页面标题 › 小标题,链接是页面地址加上这个小标题的锚点。写文档时,让每个章节回答一个问题,并用标题点明这个问题。如果某个标题的锚点不能随措辞改变,就给它一个显式 id:
## Rotate certificates {#rotate}
依据与引用#
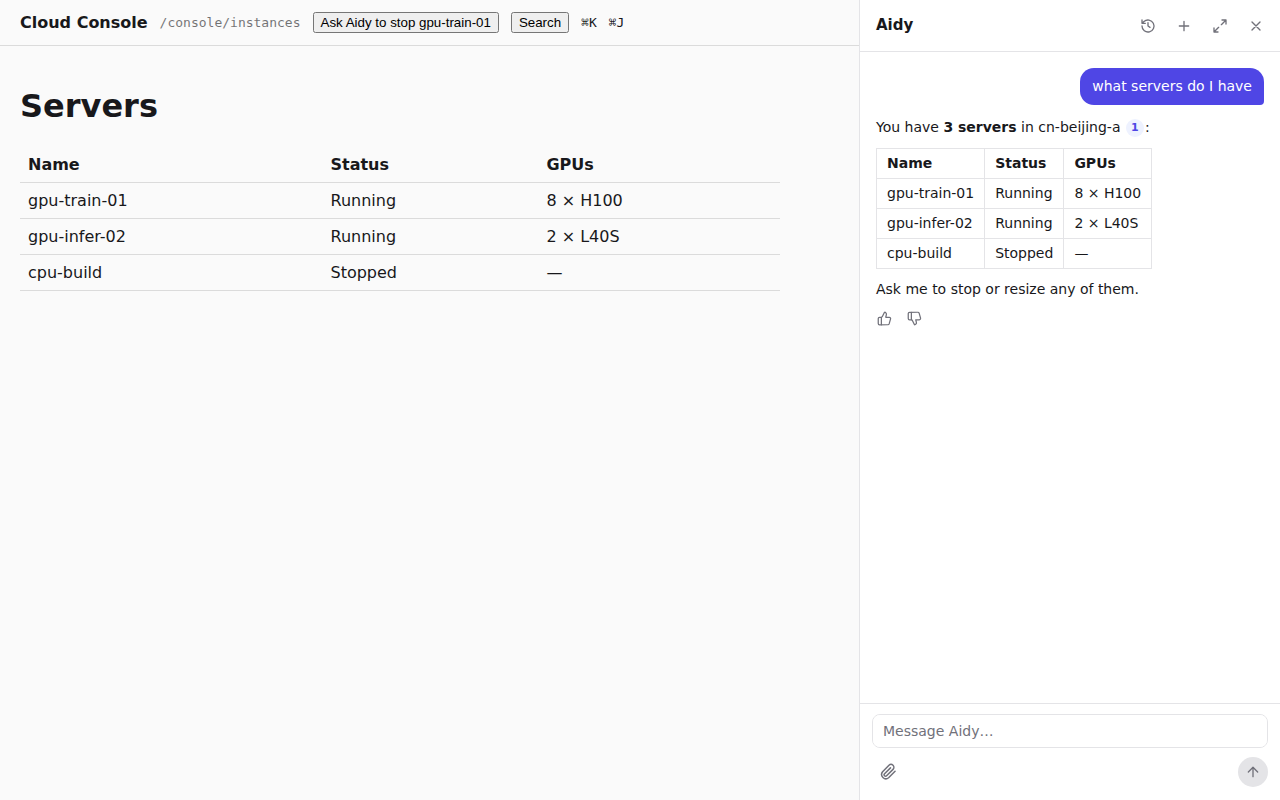
有知识时,每条新的用户消息在模型第一步之前,都会先用它的文字搜索一次(取前 200 个字符,5 条结果)。这是对话里一次普通的 search 调用,所以用户能和其他查询一起看到它。模型被要求:关于你产品的问题只依据工具结果和搜索结果回答;结果答不上来时换个说法再搜;什么都没找到时如实说明。没有知识时,Agent 在需要找东西时搜索你的 role: search 操作。
search 工具在整个运行中从 1 开始给结果编号,并把它们的 content 交给模型。回答里引用 [1] 时,运行会发出一个 rungent.citation 事件,把每个编号对应到它的结果(不含 content),面板把它渲染成指向结果 url 的链接。
接下来#
入口把 ⌘K 搜索面板和助手面板、MCP、CLI 放在一起介绍。